Modèles & crédits
Mnemosyne OS n'arrive pas avec un cerveau soudé dedans. C'est vous qui choisissez ce qui pense, et comment vous le payez.
Il n'y a aucun abonnement dans cette application.
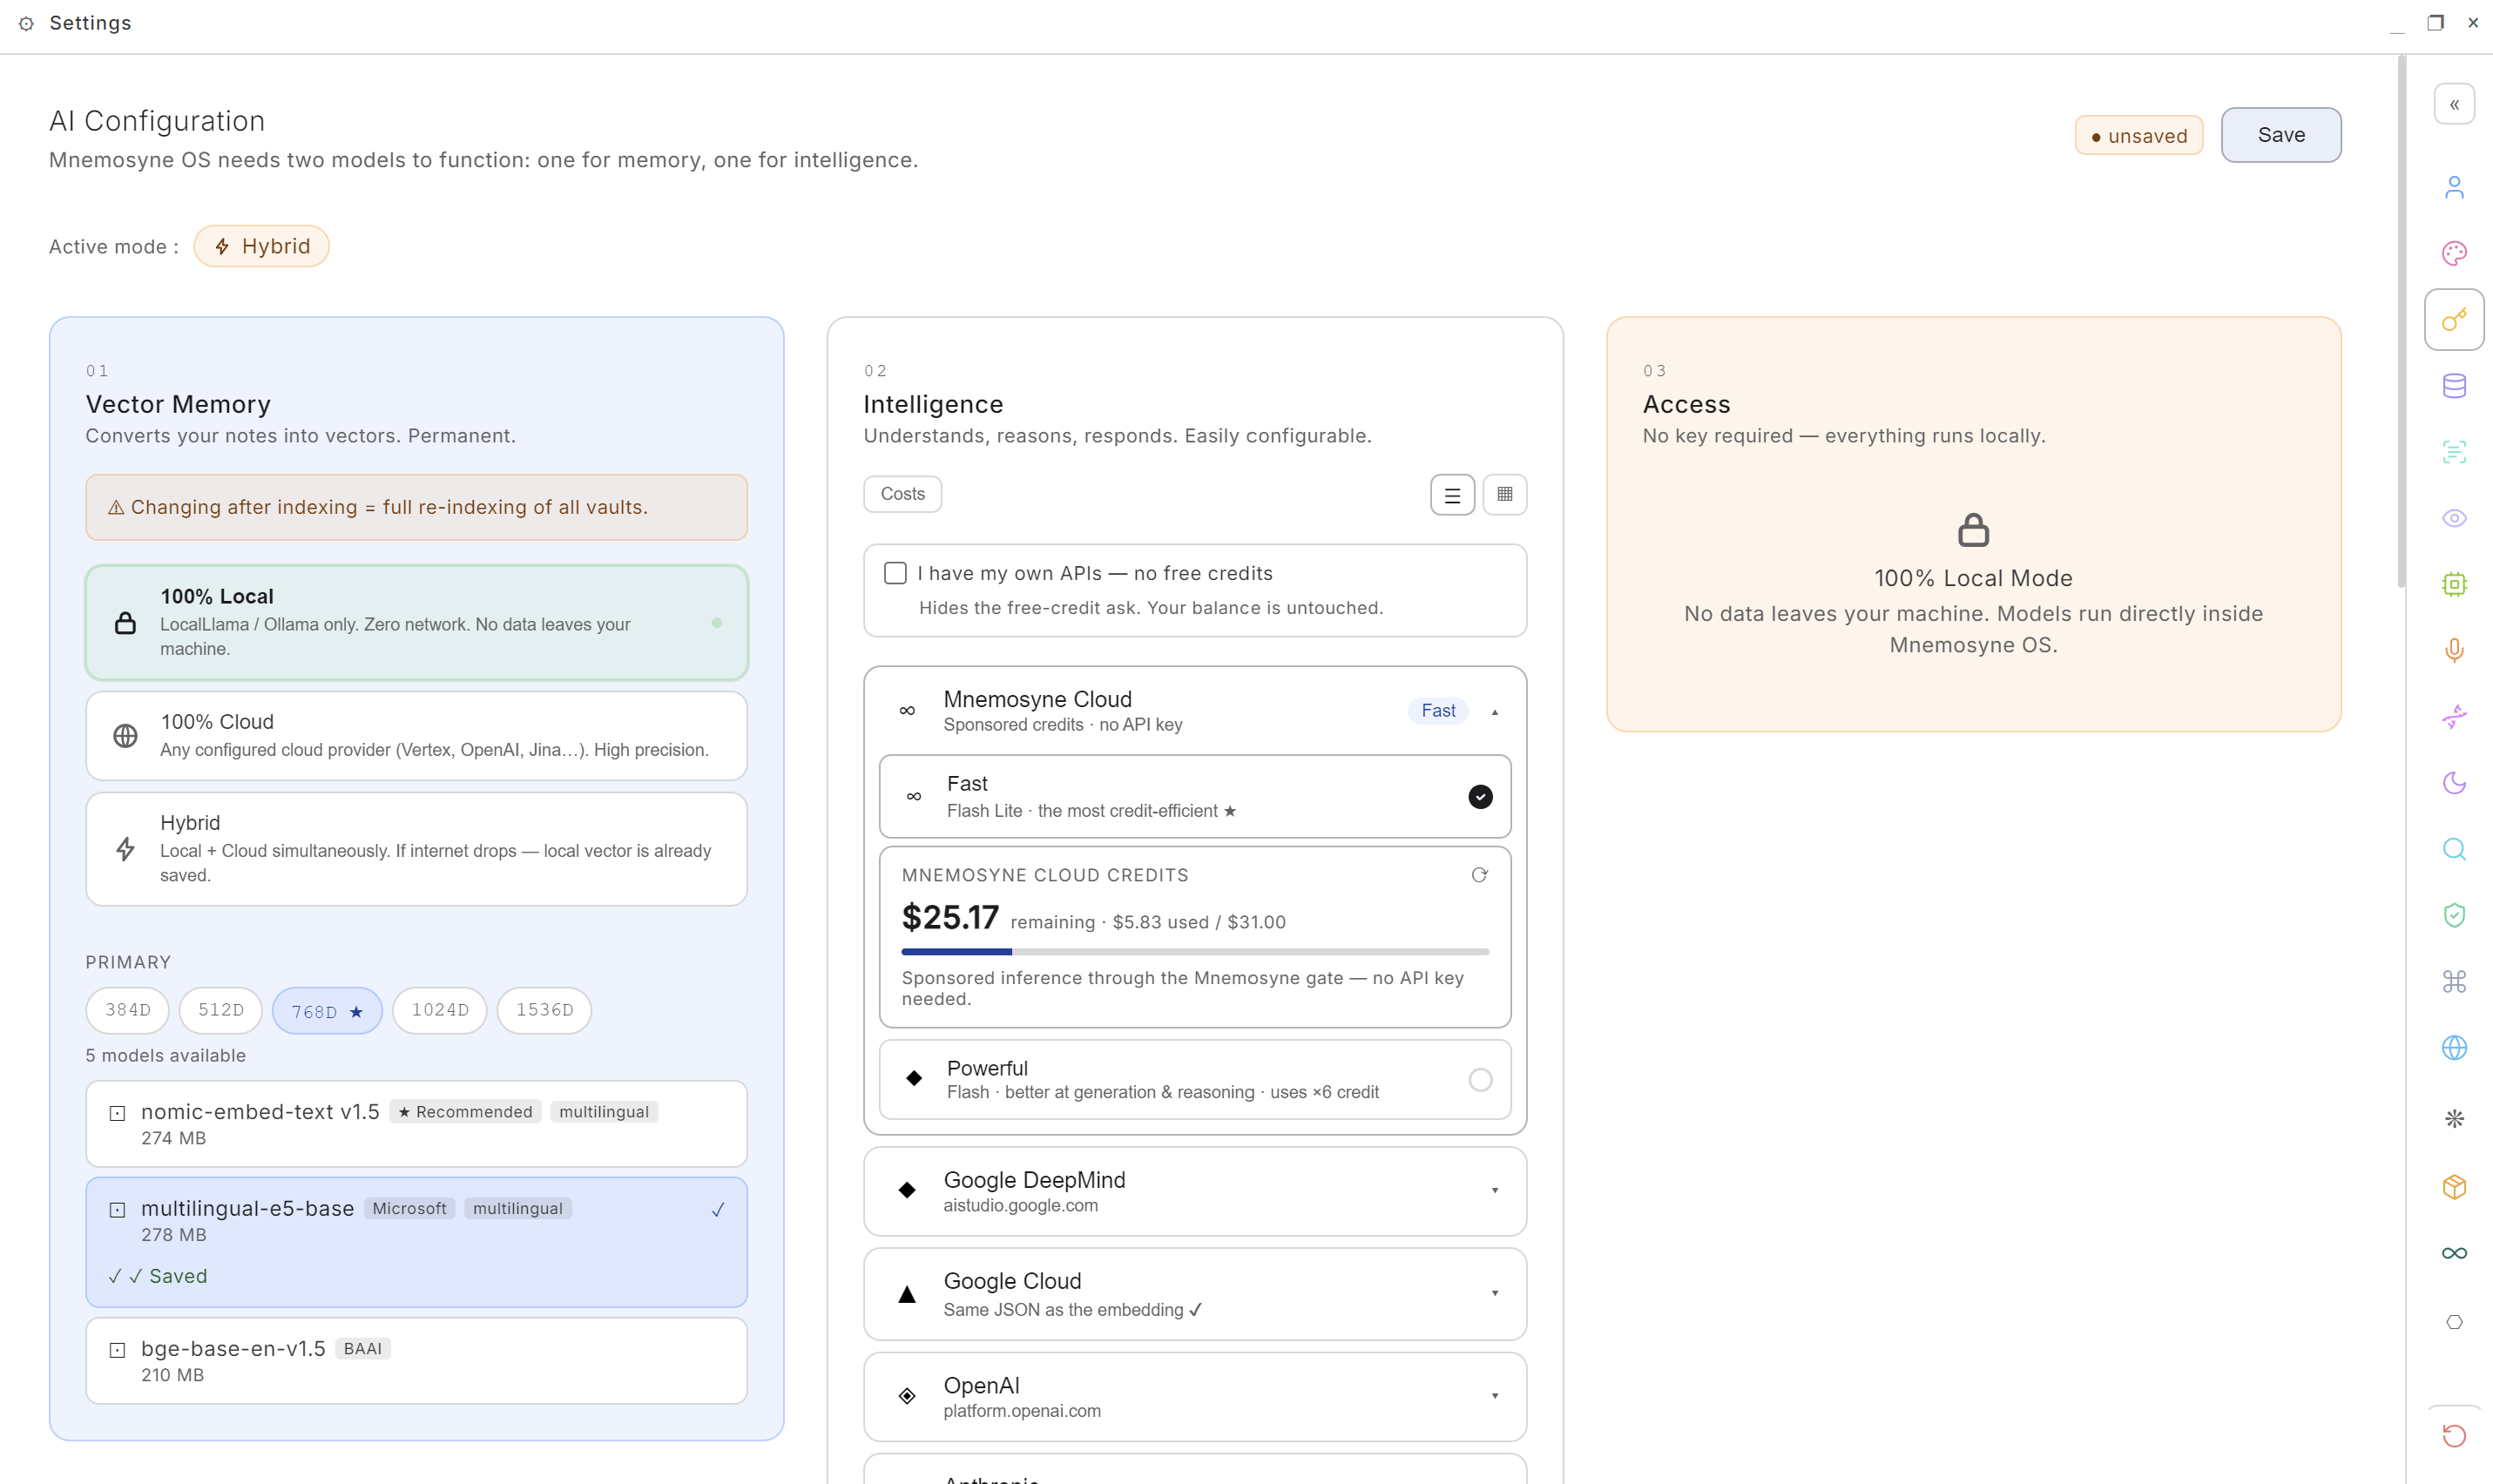
Il faut deux modèles pour la faire tourner : un pour se souvenir, un pour penser. Les deux vivent sur un seul écran, Réglages → Intelligence, intitulé Moteurs IA, avec le modèle de mémoire à gauche, le modèle qui pense au milieu, et ce que cette combinaison exige à droite.
C'est quoi, un embedding ?
Le vocabulaire d'abord, parce que tout le reste de la page repose dessus.
Un embedding transforme un morceau de texte en une liste de nombres, un point dans un espace à plusieurs centaines de dimensions. Le modèle qui le produit a été entraîné pour que le sens devienne une position : deux phrases qui disent la même chose atterrissent côte à côte même sans un mot en commun, et deux phrases qui ne partagent que du vocabulaire atterrissent loin l'une de l'autre.
C'est ce qui fait marcher la mémoire ici. Rien ne chasse des mots-clés. Votre question devient un point, et l'OS renvoie les chroniques qui en sont les plus proches. C'est pour ça que « qu'est-ce que j'avais décidé sur les prix ? » peut faire remonter une note qui ne contient jamais le mot prix.
Deux conséquences à emporter pour la suite :
- Le modèle d'embedding ne fait que placer. Il ne vous écrit jamais un mot, ne raisonne pas, ne traduit pas. Celui qui parle est un autre modèle, plus bas.
- Chaque souvenir est rangé aux coordonnées calculées par un modèle. Changez de modèle et ces coordonnées ne veulent plus rien dire, donc il faut reconstruire l'index. Cet avertissement a des dents, et il arrive juste après.
Le modèle d'embedding, celui qui se souvient
C'est la colonne de gauche de l'écran ci-dessus. Deux règles avant d'y toucher :
- Les pastilles de dimension passent en premier. 384D → 1536D filtre la liste, et 768D est la dimension native de Mnemosyne OS. Plus de dimensions donne des distinctions plus fines et un index plus lourd, moins donne plus rapide et plus léger.
- En changer après l'indexation ré-indexe tout, et l'application vous le fait confirmer. Deux modèles de même taille vivent dans des espaces vectoriels différents, donc un index construit par l'un est du bruit pour l'autre. Rien ne plante : le rappel devient simplement muet. Cette boîte de confirmation est la plus importante de l'application.
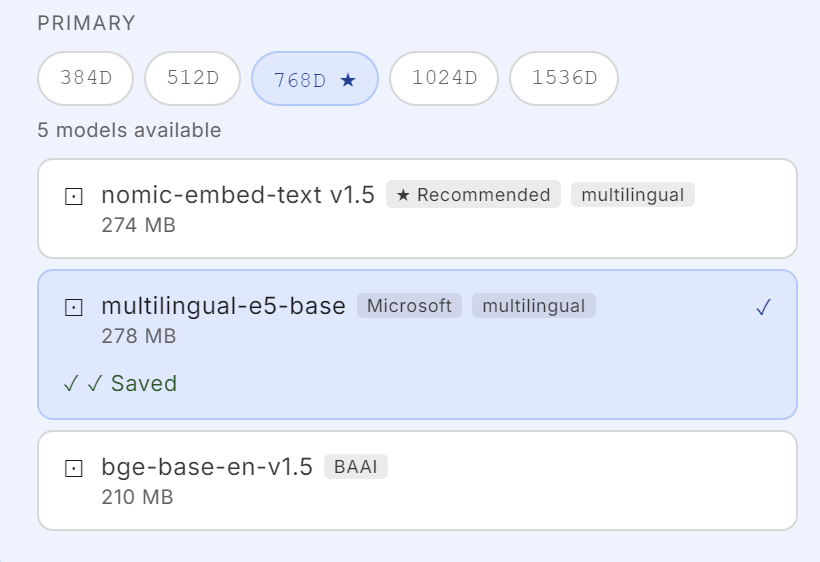
L'embedding demande peu à votre machine. Les deux modèles 768D recommandés pèsent 274 Mo et 278 Mo, les tailles que le sélecteur affiche à côté de chaque nom, et ils tournent sur le processeur. Une machine avec 16 Go de RAM encaisse le 768D sans y penser. Ce qui réclame une grosse machine, c'est un modèle local qui écrit les réponses, et c'est un autre choix, à droite du même écran.
En 768D natif, trois modèles tournent en local :
| Modèle | Taille | Fait pour |
|---|---|---|
| nomic-embed-text v1.5 | 274 Mo | l'anglais, et les longs passages (fenêtre 8 k) |
| multilingual-e5-base · Microsoft | 278 Mo | ~100 langues, et entre elles |
| bge-base-en-v1.5 · BAAI | 210 Mo | l'anglais seul |
Les autres dimensions tiennent les extrêmes : all-MiniLM-L6-v2 (22 Mo,
384D) pour la machine la plus légère possible, bge-large-en-v1.5 et
gte-large (~620 Mo, 1024D) pour la précision en anglais. Les embedders
cloud (Jina, Vertex, OpenAI) sont là si vous préférez louer ce travail
aussi.
Pourquoi E5 si vous ne pensez pas en anglais
Parce qu'un embedder centré sur l'anglais fera parler l'OS parfaitement dans votre langue et l'y fera mémoriser très mal. C'est la seule panne qu'un OS de mémoire ne peut pas se permettre : le chat est la partie qu'on voit, le rappel est la partie qui travaille.
Le modèle de chat traduit. Le modèle d'embedding projette votre phrase dans l'espace sur lequel il a été entraîné. Si cet espace a été appris presque uniquement sur de l'anglais, un modèle anglais seul a une notion fragile de ce que votre phrase veut dire, et deux de vos notes qui disent la même chose peuvent atterrir aussi loin l'une de l'autre que deux notes sans rapport. Et l'OS répond poliment qu'il ne se souvient pas.
multilingual-e5-base a été entraîné sur une centaine de langues et sur des paires entre elles, ce qui vous achète deux choses :
- Vos notes sont comparées entre elles sur le sens, dans votre langue.
- Une question posée dans une langue retrouve une note écrite dans une autre, ce qui est exactement ce qui arrive dans un vrai coffre : documentation en anglais, notes dans votre langue, une seule mémoire qui tient les deux.
C'est pour ça que l'★ du sélecteur bouge avec la langue de l'interface : l'anglais reçoit nomic, toutes les autres langues reçoivent multilingual-e5-base. L'étoile est un avis sur vous.
Le compromis : e5 lit par plus petites bouchées (une fenêtre de 512 tokens contre les 8 k de nomic) et pèse 4 Mo de plus. C'est tout le prix.
L'intelligence, les trois routes
La colonne du milieu : le modèle qui pense, raisonne et écrit. Trois façons d'en avoir un, et aucune ne vous enferme.
| Route | Ce que vous payez | Ce qui quitte votre machine |
|---|---|---|
| 100 % local | rien, jamais | rien |
| Votre propre clé (BYOK) | votre fournisseur, en direct | vos prompts, vers le fournisseur que vous avez choisi |
| Crédits Mnemosyne OS | un solde prépayé | vos prompts, via notre proxy métré |
- 100 % local : un modèle téléchargé une fois (Qwen, Gemma, Phi…) qui tourne dans votre RAM. Gratuit, privé, hors ligne. Le prix, c'est la mémoire, donc voir le tableau route-par-machine.
- Votre propre clé : Google AI, OpenAI, Anthropic, DeepSeek, Groq, Mistral, MiniMax ou Vertex AI. Votre clé est chiffrée sur cette machine, vos appels partent droit chez votre fournisseur, et nous ne prenons rien. Cochez J'ai mes propres API — pas de crédits offerts et l'application cesse de demander.
- Crédits Mnemosyne OS : aucune clé, aucun compte à ouvrir nulle part. Un solde qui descend quand vous parlez à un modèle cloud.
Vous n'êtes enfermé dans aucune route. Vous pouvez tenir les trois à la fois et changer de cerveau à chaque message depuis la pastille en haut du chat.
Les modèles locaux
La route locale vit dans cette même colonne, sous les fournisseurs cloud :
seize modèles GGUF, téléchargés une fois depuis HuggingFace et exécutés
à l'intérieur de l'application. C'est node-llama-cpp, donc il n'y a
aucun runtime externe à installer. Chaque ligne annonce son poids, son
minimum de RAM et sa fenêtre de contexte avant que vous n'engagiez le
téléchargement, et ceux déjà sur le disque portent un Téléchargé vert.
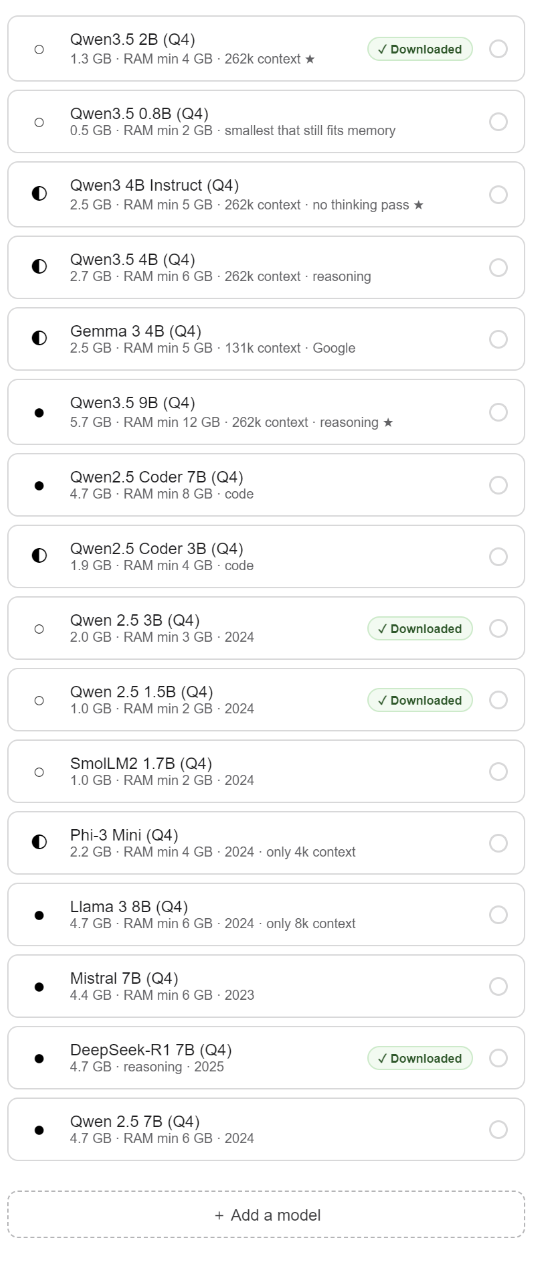
Le glyphe à gauche est la classe de taille (○ ultra-léger, ◐ léger, ● standard), et l'★ marque le choix de son étage.
| Étage | Modèles | Pour |
|---|---|---|
| Ultra-léger ○ | Qwen3.5 2B ★ · 1,3 Go, 4 Go de RAM · Qwen3.5 0.8B · 0,5 Go, 2 Go de RAM | le plancher : petites machines, et le repli |
| Léger ◐ | Qwen3 4B Instruct ★ · 2,5 Go, 5 Go de RAM · Qwen3.5 4B · 2,7 Go · Gemma 3 4B · 2,5 Go | l'étage que la plupart des gens font vraiment tourner |
| Standard ● | Qwen3.5 9B ★ · 5,7 Go, 12 Go de RAM | le raisonnement, sur une grosse machine |
| Code | Qwen2.5 Coder 7B · 4,7 Go · Coder 3B · 1,9 Go | le travail sur du code |
| Remplacés | Qwen 2.5 7B / 3B / 1.5B, SmolLM2 1.7B, Phi-3 Mini, Llama 3 8B, Mistral 7B, DeepSeek-R1 7B | gardés pour que les installations existantes continuent de marcher, chacun portant son année dans la liste |
Trois choses valent la lecture sur ces lignes :
- 262k de contexte dans toute la famille Qwen3.5, donc un petit modèle tient quand même une longue conversation et une bonne part de la mémoire rappelée.
- « no thinking pass » sur Qwen3 4B Instruct : il répond sans raisonner à voix haute d'abord. Sur une machine modeste, c'est la différence entre rapide et inutilisable. Ceux marqués reasoning réfléchissent avant de répondre, ce qui achète de meilleures réponses et des attentes plus longues.
- « only 4k context », « only 8k context » sur Phi-3 Mini et Llama 3 8B. Écrit sur le modèle.
Ajouter votre propre modèle
La liste n'est pas un jardin fermé. Tout en bas : + Ajouter un modèle.
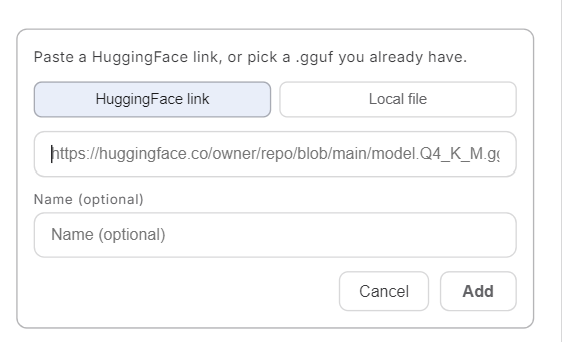
Deux portes, parce que les gens arrivent avec deux choses différentes en main :
- Un lien HuggingFace : l'adresse de la page du fichier que vous êtes en train de regarder, collée telle quelle.
- Un fichier local : un
.ggufque vous avez déjà. Si vous gardez un dossier de modèles pour un autre outil, pointez dessus. Personne ne devrait re-télécharger huit gigaoctets.
Le nom est facultatif, et le lien est vérifié avant d'être
enregistré. Un refus dit sa raison : ce fichier n'est pas un .gguf ·
ce modèle est découpé en plusieurs fichiers, prenez une quantisation en
un seul fichier · ce modèle est sous licence à accepter sur HuggingFace
d'abord · introuvable · HuggingFace injoignable. Un mauvais collage échoue
ici, en une phrase, plutôt que dix minutes plus tard en téléchargement qui
n'allait jamais aboutir.
Pourquoi des crédits, et pas un abonnement
Parce qu'un abonnement vous facture les mois où vous ne l'utilisez pas.
- Vous payez ce que vous consommez vraiment. Une semaine calme ne coûte rien.
- Rien ne se renouvelle, rien à résilier. Vous achetez un solde, il descend, il s'arrête. Pas de carte gardée en mémoire, pas de date anniversaire, pas de page de résiliation à traquer.
- Vous pouvez ne rien nous payer du tout. Apportez votre clé, ou restez en local. Les deux routes sont de première classe, et aucune ne nous envoie un centime.
Les crédits existent pour une seule raison : permettre d'utiliser un modèle cloud puissant sans ouvrir de compte chez Google ou OpenAI, sans gérer de clé d'API, et sans une ligne mensuelle sur son relevé bancaire.
La licence suit la même règle. L'Engramm est un achat unique, à vie, activé on-chain. Voir le Portefeuille souverain.
Ce que vaut un crédit
Deux paliers cloud, et le prix de chacun est écrit avant que vous ne le dépensiez, pas après :
- Rapide : Flash Lite, le plus économique en crédits.
- Puissant : Flash, meilleur en génération et raisonnement, et il le dit sur sa propre ligne, consomme ×6 de crédit.
La règle de prix, à découvert : le prix public du fournisseur × 1,35 (le coefficient d'aujourd'hui). L'écart finance le proxy, la gate de licence et le support. Le prix public est public, donc n'importe qui peut refaire le calcul.
Le texte, par million de tokens
| Palier | Le modèle derrière | Liste entrée | Liste sortie | Vous payez en entrée | Vous payez en sortie |
|---|---|---|---|---|---|
| Rapide | gemini-3.1-flash-lite | 0,25 $ | 1,50 $ | 0,34 $ | 2,03 $ |
| Puissant | gemini-3.5-flash | 1,50 $ | 9,00 $ | 2,03 $ | 12,15 $ |
Les tokens de réflexion sont facturés en sortie. Un modèle qui raisonne avant de répondre dépense du côté cher du tableau, et c'est là qu'est l'essentiel de l'écart entre les deux paliers en pratique.
Les images, par image générée
Une image ne se facture pas au token. Google publie un prix fixe par image et par palier de résolution ; le studio demande le palier 1024 px, et le tableau ci-dessous est celui-là.
| Dans le studio | Modèle | Liste | Vous payez |
|---|---|---|---|
| Flash Lite Image (par défaut) | gemini-3.1-flash-lite-image | 0,0336 $ | 0,045 $ |
| Flash Image | gemini-3.1-flash-image | 0,067 $ | 0,090 $ |
| Pro Image | gemini-3-pro-image | 0,134 $ | 0,181 $ |
| Flash Image (2.5), celui que Google a surnommé Nano Banana | gemini-2.5-flash-image | 0,039 $ | 0,053 $ |
Les prix de liste sont ceux de Google, relevés sur sa page publique : les modèles de texte le 29/07/2026, les modèles d'image le 27/08/2026. Le coefficient peut changer, et les prix de liste bougent quand Google les bouge : lisez ce tableau comme daté, pas comme un contrat. Ce qui ne change pas, c'est la règle : un prix de liste, une multiplication, à un seul endroit.
La recharge, les codes et la barre de solde vivent dans le Portefeuille souverain.
Le journal des coûts
Le bouton Coûts est en haut de la colonne Intelligence, sur l'écran ci-dessus. Il ouvre le journal : chaque appel, son modèle, son coût.
Deux sections qui ne sont jamais fusionnées, parce que ce ne sont pas des nombres de même nature :
- Débité · Mnemosyne Cloud : ce que la gate a réellement facturé. Un chiffre qui fait autorité, calculé de leur côté.
- Estimé · votre propre clé : ces appels partent de votre machine vers votre fournisseur, et le détail facturé reste chez lui. Vous renseignez votre tarif ($ / 1M tokens), l'OS compte les tokens.
Un appel dont le prix ne peut pas être connu n'affiche rien, jamais un zéro. Un zéro affirmerait que c'était gratuit. Le total dit combien d'appels il a su chiffrer, et combien il n'a pas su.
Ce que « 100 % local » veut dire vraiment
Modèle local et embeddings locaux : la pensée et la mémoire restent toutes les deux à la maison. Aucun prompt, aucune chronique, aucun index ne quitte la machine.
Le widget Diagnostics système compte chaque octet que l'application met sur le réseau, en direct, depuis le lancement.