Modelos y créditos
Mnemosyne OS no llega con un cerebro soldado dentro. Tú eliges qué piensa, y eliges cómo lo pagas.
No hay ninguna suscripción en esta aplicación.
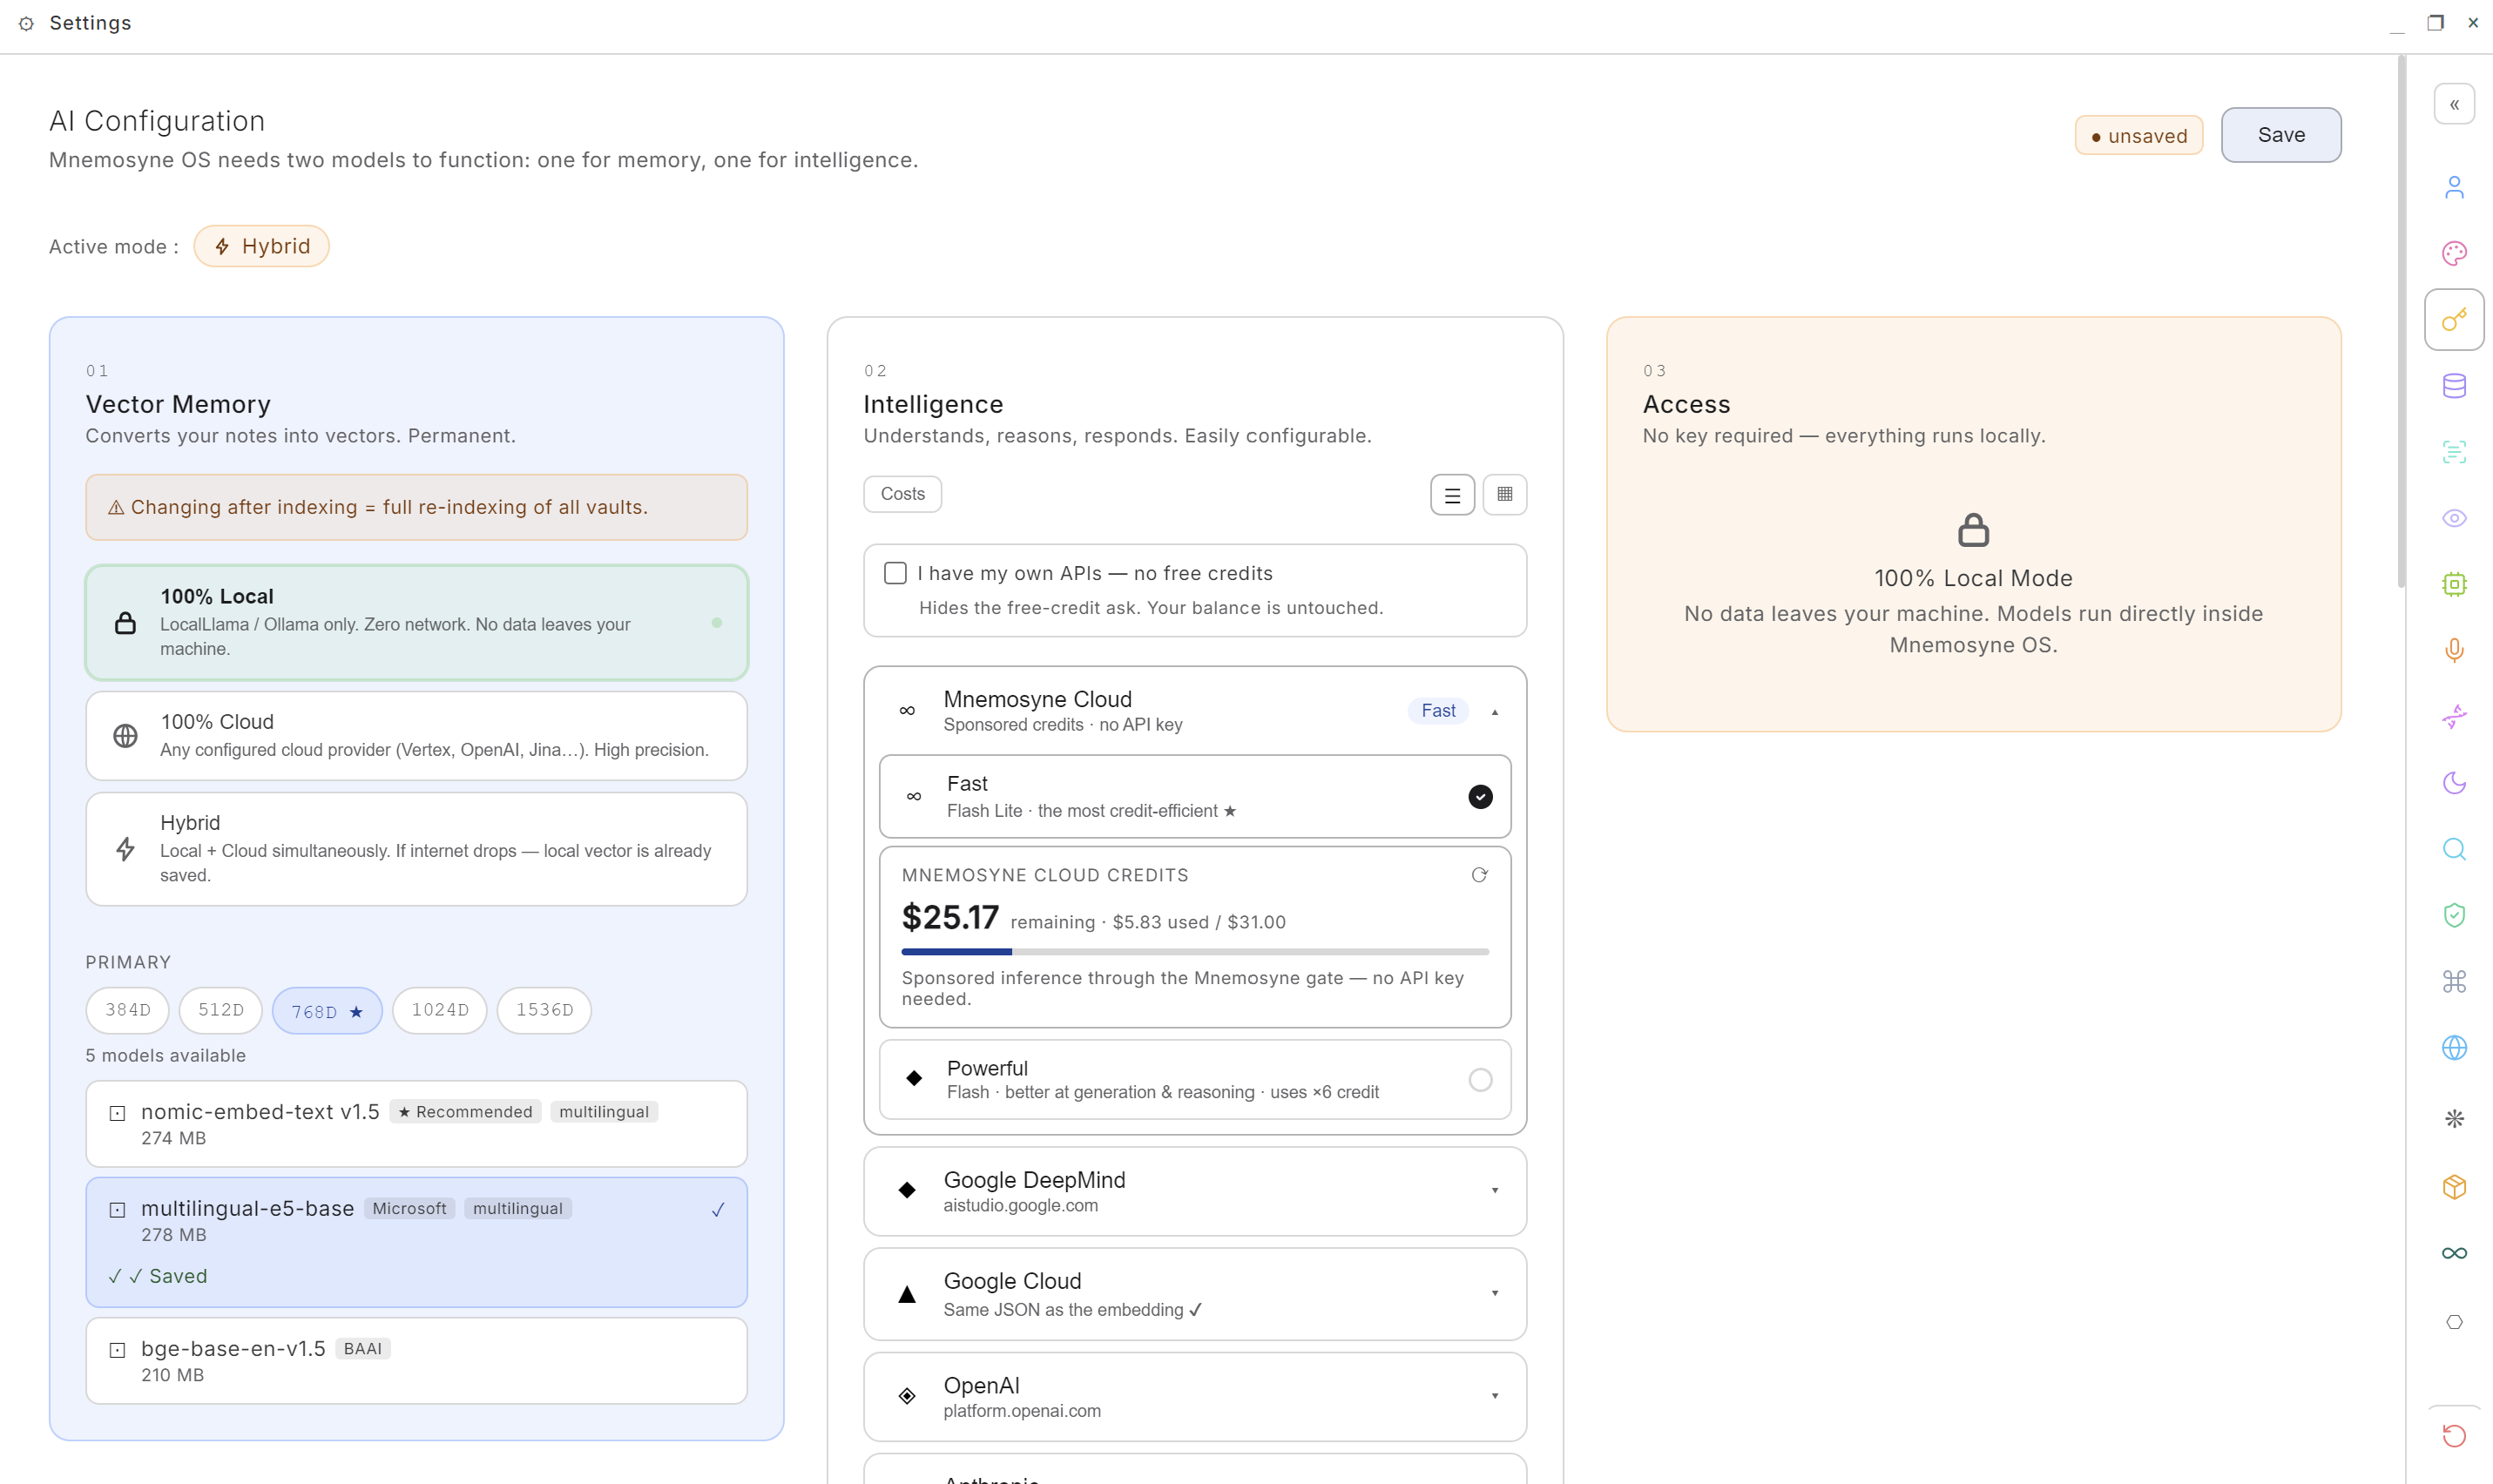
Hacen falta dos modelos para que funcione: uno para recordar, otro para pensar. Los dos viven en una sola pantalla, Ajustes → Inteligencia, titulada Motores IA, con el modelo de memoria a la izquierda, el que piensa en el centro, y lo que esa combinación exige a la derecha.
Qué es un embedding
El vocabulario primero, porque el resto de la página se apoya en él.
Un embedding convierte un trozo de texto en una lista de números: un punto en un espacio de varios cientos de dimensiones. El modelo que lo produce fue entrenado para que el significado se vuelva posición: dos frases que dicen lo mismo caen una al lado de la otra aunque no compartan ni una palabra, y dos que solo comparten vocabulario caen lejos.
Eso es lo que hace que la memoria funcione aquí. Nada persigue palabras clave. Tu pregunta se convierte en un punto, y el OS devuelve las crónicas que se sientan más cerca. Por eso «¿qué decidí sobre los precios?» puede sacar a la luz una nota que nunca contiene la palabra precios.
Dos consecuencias que conviene llevarse al resto de la página:
- El modelo de embedding nunca te escribe una palabra. No responde, no razona, no traduce. Solo coloca. El que habla es otro modelo, más abajo.
- Cada recuerdo queda archivado en las coordenadas que calculó un modelo. Cambia el modelo y esas coordenadas ya no significan nada, así que hay que reconstruir el índice. Ese aviso tiene dientes, y llega justo después.
El modelo de embedding, el que recuerda
Es la columna izquierda de la pantalla de arriba. Dos reglas antes de tocarlo:
- Las píldoras de dimensión van primero. 384D → 1536D filtra la lista; 768D es la dimensión nativa de Mnemosyne OS. Más dimensiones = distinciones más finas y un índice más pesado, menos = más rápido y más ligero.
- Cambiarlo después de indexar reindexa todo, y la aplicación te lo hace confirmar. Dos modelos del mismo tamaño no comparten el mismo espacio vectorial, así que un índice construido por uno es ruido para el otro. Nada se rompe: la recuperación simplemente enmudece. Ese diálogo de confirmación es el más importante de la aplicación.
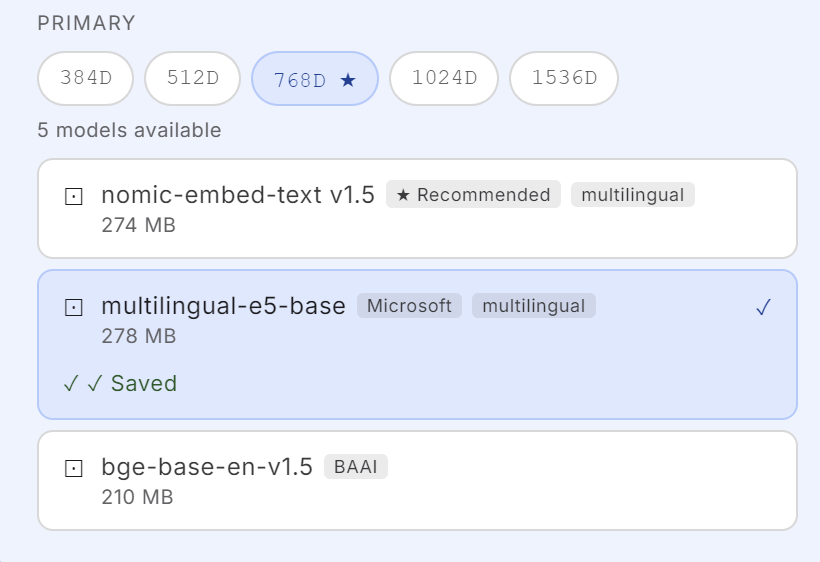
El embedding pide poco a tu máquina. Los dos modelos 768D recomendados pesan 274 MB y 278 MB, los tamaños que el selector muestra junto a cada nombre, y corren en el procesador. Una máquina con 16 GB de RAM lleva el 768D sin pensarlo. Lo que pide una máquina grande es un modelo local que escribe las respuestas, y esa es otra elección, a la derecha de la misma pantalla.
En los 768D nativos, tres modelos corren en local:
| Modelo | Tamaño | Hecho para |
|---|---|---|
| nomic-embed-text v1.5 | 274 MB | el inglés, y los pasajes largos (ventana de 8 k) |
| multilingual-e5-base · Microsoft | 278 MB | ~100 idiomas, y entre ellos |
| bge-base-en-v1.5 · BAAI | 210 MB | solo inglés |
Las otras dimensiones sostienen los extremos: all-MiniLM-L6-v2
(22 MB, 384D) para la máquina más ligera posible, bge-large-en-v1.5 y
gte-large (~620 MB, 1024D) para la precisión en inglés. Los
embedders en la nube (Jina, Vertex, OpenAI) están ahí si prefieres
alquilar también ese trabajo.
Por qué E5 si no piensas en inglés
Porque un embedder centrado en el inglés hará que el OS hable tu idioma a la perfección y lo recuerde fatal. Es el único fallo que un OS de memoria no se puede permitir: el chat es la parte que se ve, la recuperación es la parte que es el producto.
El modelo de chat traduce. El de embedding no: proyecta tu frase en el espacio con el que fue entrenado. Si ese espacio se aprendió casi solo con inglés, un modelo únicamente inglés no tiene una noción fiable de lo que tu frase significa, y dos notas tuyas que dicen lo mismo pueden caer tan lejos entre sí como dos notas sin relación. Y el OS responde, educadamente, que no lo recuerda.
multilingual-e5-base se entrenó con un centenar de idiomas y con pares entre ellos, lo que te compra dos cosas:
- Tus notas se comparan entre sí por el significado, en tu idioma.
- Una pregunta en un idioma encuentra una nota escrita en otro, que es justo lo que pasa en una bóveda real: documentación en inglés, notas en tu idioma, y una sola memoria que sostiene ambas.
Por eso la ★ del selector se mueve con el idioma de la interfaz: el inglés recibe nomic, todos los demás idiomas reciben multilingual-e5-base. La estrella es una opinión sobre ti.
El compromiso: e5 lee a bocados más pequeños (una ventana de 512 tokens frente a los 8 k de nomic) y pesa 4 MB más. Ese es todo el precio.
La inteligencia, las tres rutas
La columna central: el modelo que piensa, razona y escribe. Tres maneras de tener uno, y ninguna te encierra.
| Ruta | Lo que pagas | Lo que sale de tu máquina |
|---|---|---|
| 100 % local | nada, nunca | nada |
| Tu propia clave (BYOK) | tu proveedor, directamente | tus prompts, hacia el proveedor que elegiste |
| Créditos Mnemosyne OS | un saldo prepagado | tus prompts, a través de nuestro proxy medido |
- 100 % local: un modelo descargado una vez (Qwen, Gemma, Phi…) que corre en tu RAM. Gratis, privado, sin conexión. El precio es la memoria: mira la tabla ruta-por-máquina.
- Tu propia clave: Google AI, OpenAI, Anthropic, DeepSeek, Groq, Mistral, MiniMax o Vertex AI. Tu clave se cifra en esta máquina, tus llamadas van directas a tu proveedor y nosotros no nos llevamos nada. Marca Tengo mis propias API — sin créditos gratis y la aplicación deja de preguntar.
- Créditos Mnemosyne OS: sin clave, sin cuenta que abrir en ningún sitio. Un saldo que baja cuando hablas con un modelo en la nube.
No te encierras en ninguna ruta. Puedes tener las tres a la vez y cambiar de cerebro en cada mensaje desde la píldora en la parte superior del chat.
Los modelos locales
La ruta local vive en esa misma columna, debajo de los proveedores en la
nube: dieciséis modelos GGUF, descargados una vez
desde HuggingFace y ejecutados dentro de la aplicación. Esto es
node-llama-cpp, así que no hay ningún runtime externo que instalar.
Cada línea declara su peso, su mínimo de RAM y su ventana de contexto
antes de que te comprometas a la descarga, y los que ya están en
disco llevan un Descargado verde.
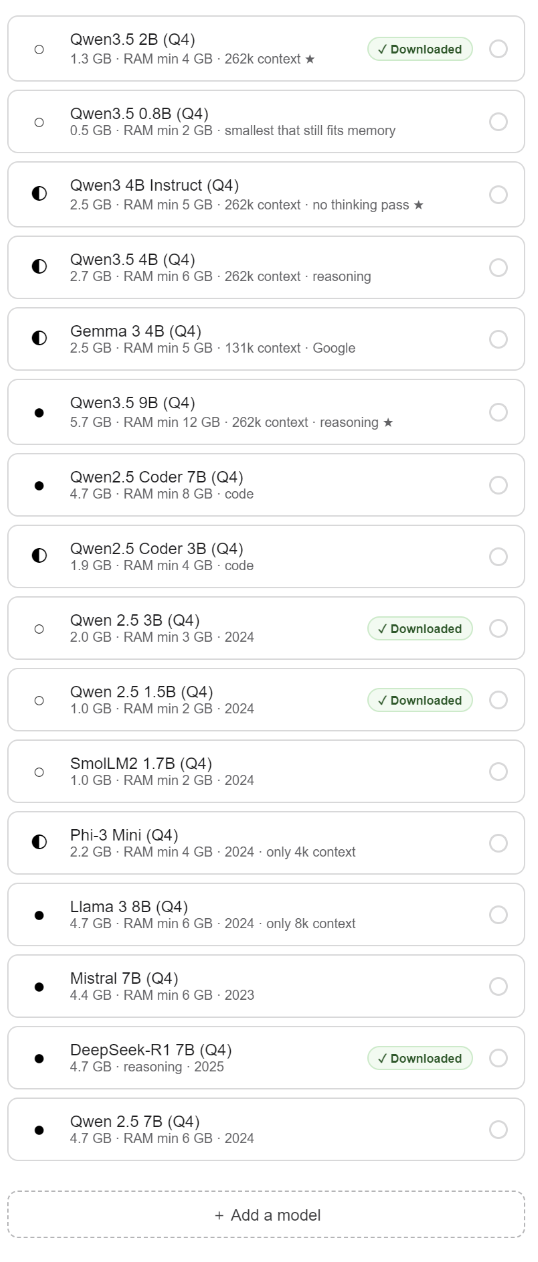
El glifo de la izquierda es la clase de tamaño (○ ultraligero, ◐ ligero, ● estándar), y la ★ marca la elección de su nivel.
| Nivel | Modelos | Para |
|---|---|---|
| Ultraligero ○ | Qwen3.5 2B ★ · 1,3 GB, 4 GB de RAM · Qwen3.5 0.8B · 0,5 GB, 2 GB de RAM | el suelo: máquinas pequeñas, y el repliegue |
| Ligero ◐ | Qwen3 4B Instruct ★ · 2,5 GB, 5 GB de RAM · Qwen3.5 4B · 2,7 GB · Gemma 3 4B · 2,5 GB | el nivel que la mayoría realmente ejecuta |
| Estándar ● | Qwen3.5 9B ★ · 5,7 GB, 12 GB de RAM | razonamiento, en una máquina grande |
| Código | Qwen2.5 Coder 7B · 4,7 GB · Coder 3B · 1,9 GB | trabajo sobre código |
| Sustituidos | Qwen 2.5 7B / 3B / 1.5B, SmolLM2 1.7B, Phi-3 Mini, Llama 3 8B, Mistral 7B, DeepSeek-R1 7B | conservados para que las instalaciones existentes sigan funcionando, cada uno llevando su año en la lista |
Tres cosas que vale la pena leer en esas líneas:
- 262k de contexto en toda la familia Qwen3.5, así que un modelo pequeño aun así sostiene una conversación larga y una buena porción de la memoria recuperada.
- «no thinking pass» en Qwen3 4B Instruct: responde sin razonar en voz alta primero. En una máquina modesta esa es la diferencia entre rápido e inservible. Los marcados reasoning piensan antes de responder, lo que compra mejores respuestas y esperas más largas.
- «only 4k context», «only 8k context» en Phi-3 Mini y Llama 3 8B. Escrito sobre el modelo.
Añade tu propio modelo
La lista no es un jardín vallado. Al final de ella: + Añadir un modelo.
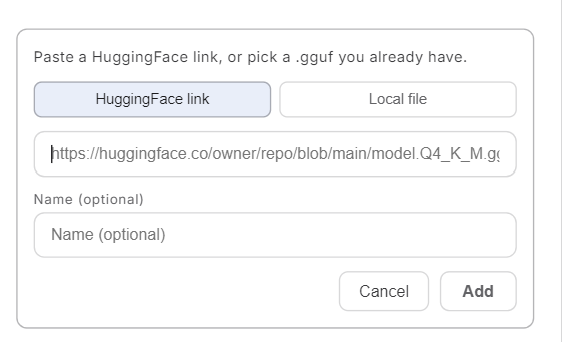
Dos puertas, porque la gente llega con dos cosas distintas en la mano:
- Un enlace de HuggingFace: la dirección de la página del archivo que estás mirando, pegada tal cual. No owner/repo y archivo.gguf en dos campos separados.
- Un archivo local: un
.ggufque ya tienes. Si guardas una carpeta de modelos para otra herramienta, apunta ahí: nadie debería volver a descargar ocho gigabytes.
El nombre es opcional, y el enlace se comprueba antes de guardarse.
Un rechazo dice su motivo: ese archivo no es un .gguf · este modelo
está partido en varios archivos, elige una cuantización de un solo
archivo · este modelo está restringido, acepta su licencia en HuggingFace
primero · no encontrado · no se pudo alcanzar HuggingFace. Un pegado malo
falla aquí, en una frase, en vez de diez minutos después como una
descarga que nunca iba a terminar.
Por qué créditos, y no una suscripción
Porque una suscripción te cobra los meses en que no la usas.
- Pagas lo que realmente ejecutas. Una semana tranquila no cuesta nada.
- Nada se renueva, nada que cancelar. Compras un saldo, baja, y se detiene. Sin tarjeta guardada, sin fecha de aniversario, sin página de baja que buscar.
- Puedes no pagarnos absolutamente nada. Trae tu propia clave, o quédate en local. Ambas rutas son de primera clase, y ninguna nos envía un céntimo.
Los créditos existen por una sola razón: permitir usar un modelo potente en la nube sin abrir una cuenta en Google u OpenAI, sin gestionar una clave de API y sin una línea mensual en el extracto bancario.
La licencia sigue la misma regla. El Engramm es una compra única, de por vida, activada on-chain. Mira la Cartera soberana.
Cuánto vale un crédito
Dos niveles en la nube, y el precio de cada uno está escrito antes de que lo gastes, no después:
- Rápido: Flash Lite, el más económico en créditos.
- Potente: Flash, mejor en generación y razonamiento, y lo dice en su propia línea: consume ×6 de crédito.
La regla de precio, a la vista: el precio público del proveedor × 1,35 (el coeficiente de hoy). La diferencia financia el proxy, la gate de licencias y el soporte. El precio de lista es público, así que cualquiera puede rehacer la cuenta.
El texto, por millón de tokens
| Nivel | El modelo detrás | Lista entrada | Lista salida | Pagas entrada | Pagas salida |
|---|---|---|---|---|---|
| Rápido | gemini-3.1-flash-lite | 0,25 $ | 1,50 $ | 0,34 $ | 2,03 $ |
| Potente | gemini-3.5-flash | 1,50 $ | 9,00 $ | 2,03 $ | 12,15 $ |
Los tokens de razonamiento se facturan como salida. Un modelo que razona antes de responder gasta por el lado caro de la tabla, y ahí está buena parte de la diferencia entre los dos niveles en la práctica.
Las imágenes, por imagen generada
Una imagen no se factura por token. Google publica un precio fijo por imagen y por nivel de resolución; el estudio pide el nivel de 1024 px, y la tabla de abajo es esa.
| En el estudio | Modelo | Lista | Pagas |
|---|---|---|---|
| Flash Lite Image (por defecto) | gemini-3.1-flash-lite-image | 0,0336 $ | 0,045 $ |
| Flash Image | gemini-3.1-flash-image | 0,067 $ | 0,090 $ |
| Pro Image | gemini-3-pro-image | 0,134 $ | 0,181 $ |
| Flash Image (2.5), el que Google apodó Nano Banana | gemini-2.5-flash-image | 0,039 $ | 0,053 $ |
Los precios de lista son los de Google, leídos en su página pública: los modelos de texto el 29/07/2026, los de imagen el 27/08/2026. El coeficiente puede cambiar, y los precios de lista se mueven cuando Google los mueve: lee la tabla como fechada, no como un contrato. Lo que no cambia es la regla: un precio de lista, una multiplicación, en un solo sitio.
La recarga, los códigos y la barra de saldo viven en la Cartera soberana.
El registro de costes
El botón Costes está arriba en la columna Inteligencia, en la pantalla de arriba. Abre el registro: cada llamada, su modelo, su coste.
Dos secciones que nunca se fusionan, porque no son números de la misma naturaleza:
- Cobrado · Mnemosyne Cloud: lo que la gate cobró de verdad. Una cifra con autoridad, no nuestra aritmética.
- Estimado · tu propia clave: esas llamadas van de tu máquina a tu proveedor; el detalle facturado está allí, y no nos es conocido. Tú introduces tu tarifa ($ / 1M tokens), el OS cuenta los tokens.
Y lo que cuesta algo: una llamada cuyo precio no se puede conocer no muestra nada, nunca un cero. Un cero afirmaría que fue gratis. El total dice cuántas llamadas pudo tarifar y cuántas no.
Qué significa realmente «100 % local»
Modelo local y embeddings locales: el pensamiento y la memoria se quedan los dos en casa. Ningún prompt, ninguna crónica, ningún índice sale de la máquina.
El widget Diagnóstico del sistema cuenta cada byte que la aplicación pone en la red, en vivo, desde el arranque.